


本文由 AI 从英文翻译 · 查看英文原文
Post · article
我管理了 16 个 AI Agent 整整 30 天,结果我成了瓶颈
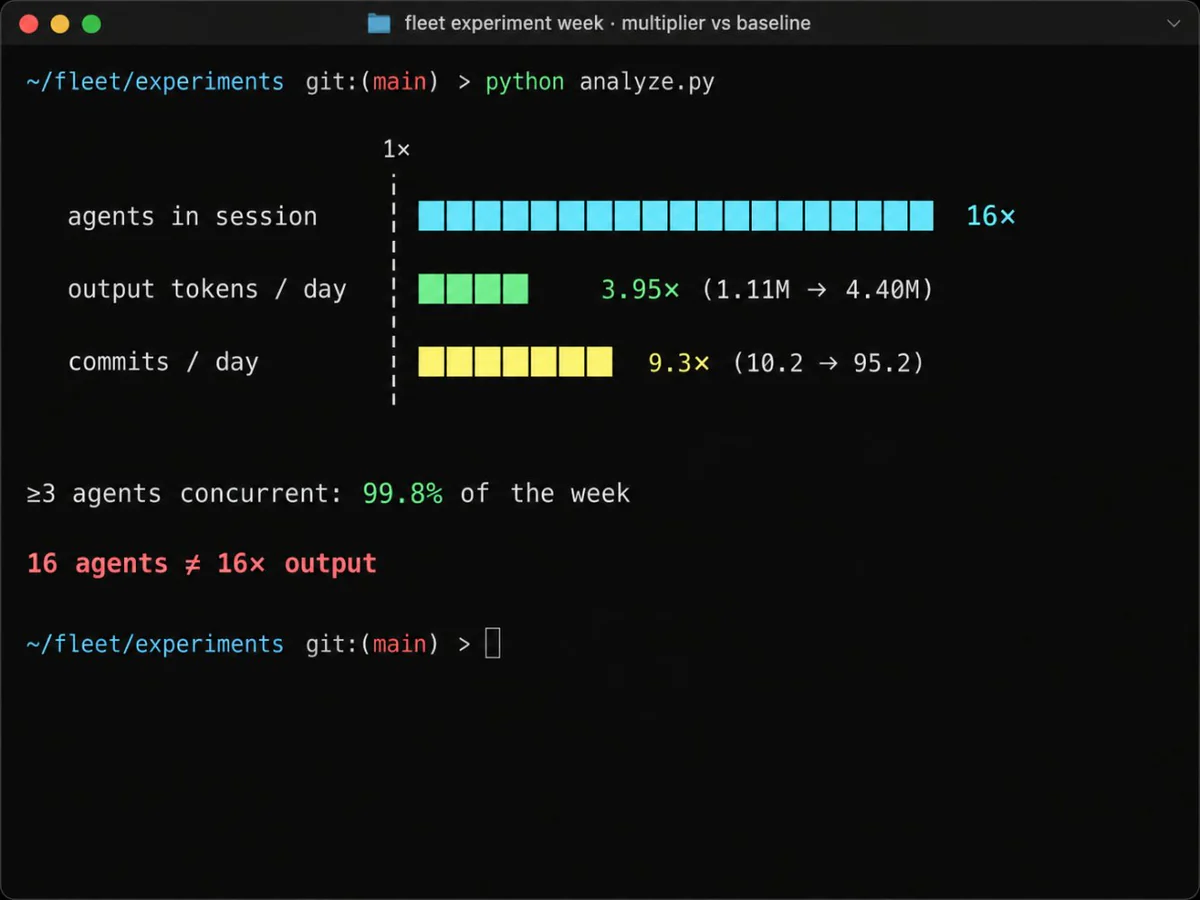
最多同时跑着 16 个 AI agent,30 天的 Claude Code 和 Herdr 日志告诉我:限制我的从来不是 token,而是我的注意力,和我验收这些工作的能力。
对我 30 天的 @claudeai code @AnthropicAI .jsonl,以及 @cancelik 的 @herdrdev 日志的一次研究。
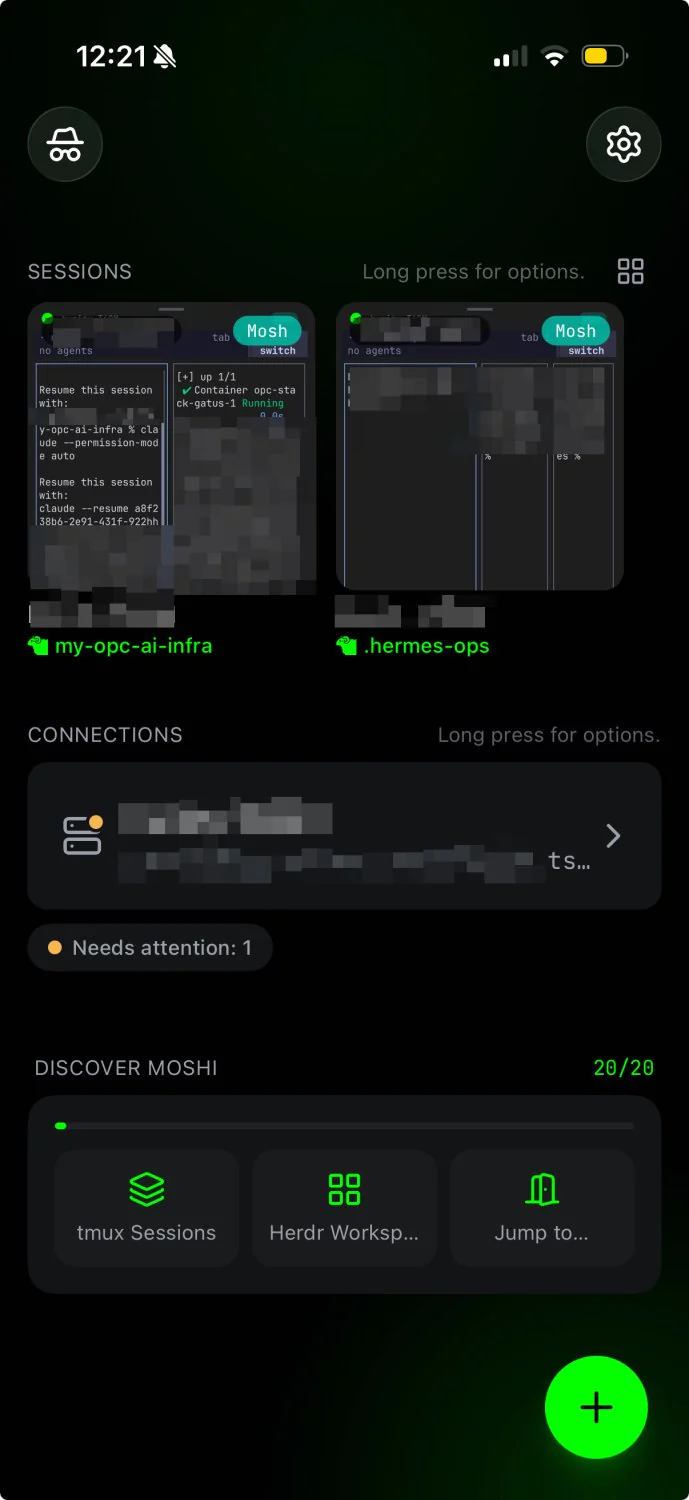
除了睡觉、吃饭和去健身房,我一直靠 @odd_joel 做的 Moshi 这类手机 app 保持在线,随时和 Herdr 里的 agent 互动。
注:
- 我没有把派生出来的 sub agent 算进去。
- 我说“认真”,指的是给出扎实的输入,去检查、review、验证,而不是一路点 yes,或者开着 yolo 模式放飞!
- 这些都是正经的软件应用项目,不是为了 vibe coding demo 做的玩具 app,也就是说,每一个都走完了完整的开发生命周期:QA、验证、UAT、打回、修正等等。
所以到最后,我没有把 token 用完,我把自己用完了。
我的配置
- 我用 Herdr 当运行时:多个 coding agent,各自活在自己的终端窗格里,工作中、被卡住、空闲,状态一目了然。
- 我用 @Larksuite(打了激素的 Slack)当 agent 的运营层。Context、计划、调研、决策和产出物,全部流回同一个地方。
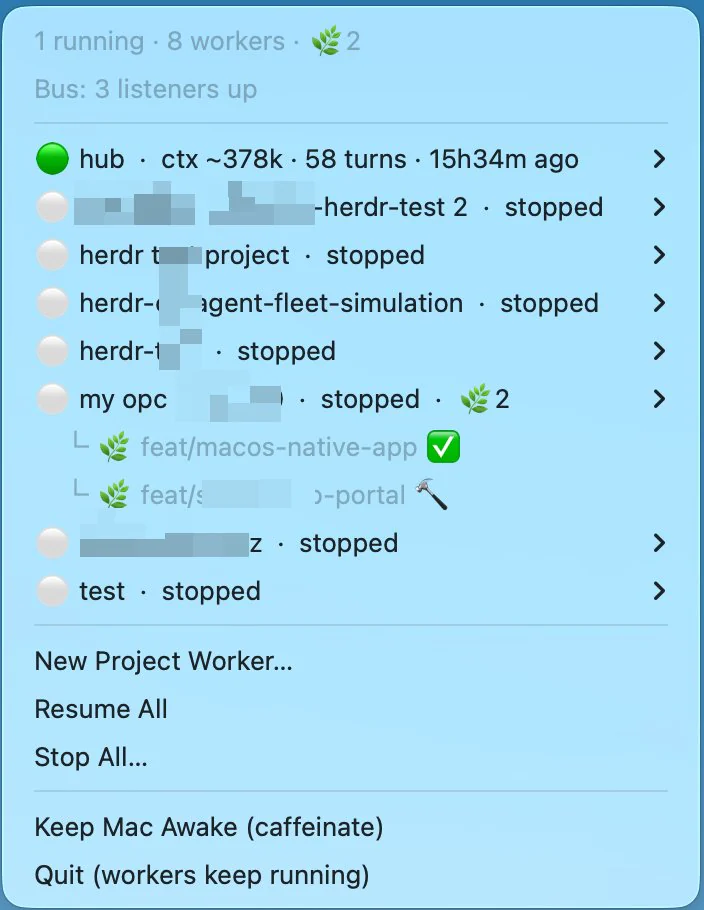
- 我还给自己做了一个迷你版的 Xirp(@SpotifyEng 出品,在 Spotify Backstage 上可用,是一个 agent 管理应用)。通过一条终端隧道,我能看到各个 session 和 worktree 的状态。这样一来,不管我的 agent 是在我的个人笔记本上做项目,还是在服务器上,我都只需要一个地方来聊天和监控状态,而且所有 agent 共享同一份 context、session memory,还有一些 skill:agent 会自动建一个 Lark 频道,就像 @SlackHQ 的 code channel 那样,再把状态更新到 Lark 的多维表格(bitable)里,就像 @airtable,还有像 @jira 那样的看板视图
我最初的理论,是关于 token 吞吐量的
对于一个固定的模型和服务,有几个变量是相对稳定的:
- 首个 token 的延迟(time to first token)
- 每秒 token 数
- 模型能力
- API 价格和速率限制
一天还是 24 小时。我的注意力是有限的。
剩下唯一一个我能改变、而且威力很大的变量:并发(concurrency)🤔
如果一个 agent 一天能产出一定量的有用工作,那同时跑几个 agent,我的产出就应该成倍增长。而如果 agent 还能把任务委派给别的 agent,这份产能也许会涨得更快。
一开始,感觉确实如此。
一个 agent 在写代码的时候,另一个可以做调研。
第三个可以排查 bug。
第四个可以准备文档。
Herdr 让我很容易看清,哪个 agent 在往前跑,哪个在等我。
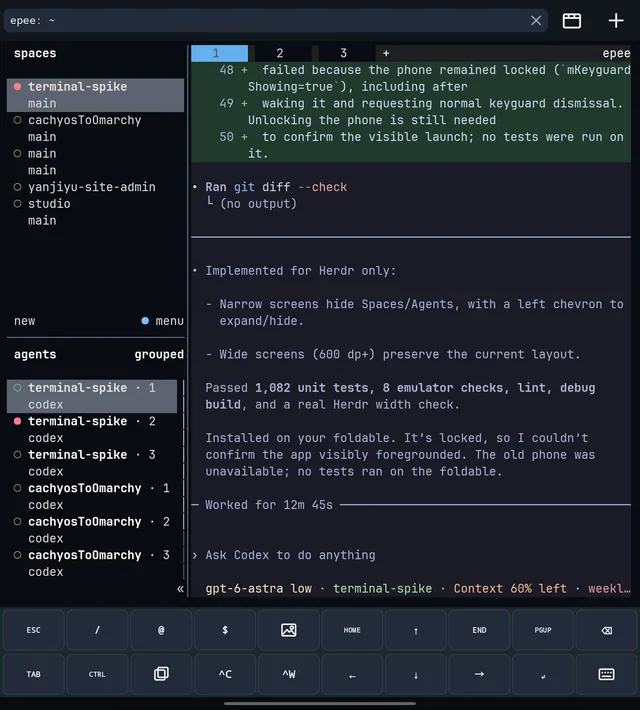
不是我的 Herdr 工作区,但差不多
我消耗的 token 更多了,但更重要的是,我在指挥更多的工作。
后来,舰队快到足以暴露出下一个约束。
第一堵墙是注意力
据说 OpenClaw 的作者 Peter Steinberger 说得特别到位:
“六个月前,我的瓶颈是 token。后来我加入了 OpenAI。现在我的瓶颈是注意力。”
我几乎立刻就感受到了。
再开一个 agent 很便宜。给它一个任务很便宜。让它跑起来也很便宜。
但每一个 agent,都在预支我未来的注意力。
总有某个时刻,
- 它需要你澄清需求。
- 它会做出一个我没预料到的决定。
- 它做完了,请你 review。
更糟的是,活儿只是表面上做完了,它却信心满满地宣布成功。
我可以再喝一罐红牛,可以少睡一点,可以在更多终端窗格之间来回跳。
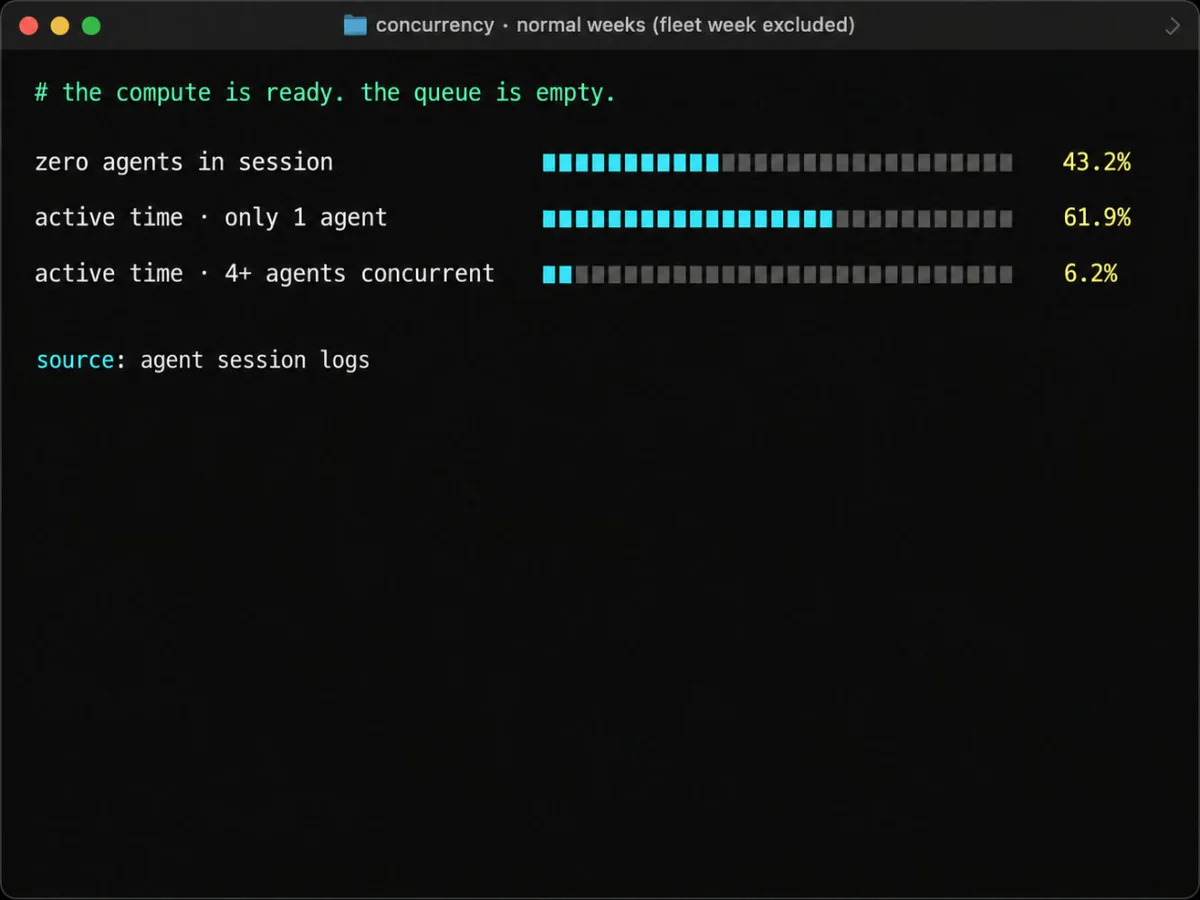
你也看到了,过去 30 天里,agent 大约有 40% 的时间仍在等我——我习惯在睡前尽可能多地开 session,但大多数时候,agent 还是在等我的输入。
更多的 agent 并不会抬高注意力的天花板,只会让你更快撞上它。
更深的一堵墙,是验证
这时候,Jason Wei 的博客 Asymmetry of Verification and Verifier’s Rule 开始让我有了更深的体会。
Jason 现在在 Meta Superintelligence Labs,他讲了这样一个现象:有些问题,验证起来比解决起来容易得多。一道数独可能要花很久才能解出来,但检查一个已经填好的答案相对容易。
这种不对称对 AI 来说价值巨大:如果一个解能被快速、客观地评估,系统就可以生成并测试大量候选方案。
但不是所有产品工作都有这种性质。
有时候,验证一个 agent 的产出,几乎和自己手动做一遍一样久。有时候甚至更久。
一个 agent 几分钟就能实现一个 feature。可我还是得打开产品,搞清楚改了什么,测主流程,试边界情况,把结果和我最初的意图对比,再判断它用起来是不是真的对。
最后这一点很重要。
测试能告诉我按钮能不能用,却不一定能告诉我,产品是不是变得更好了。
这就是我真正撞上的极限:UAT。
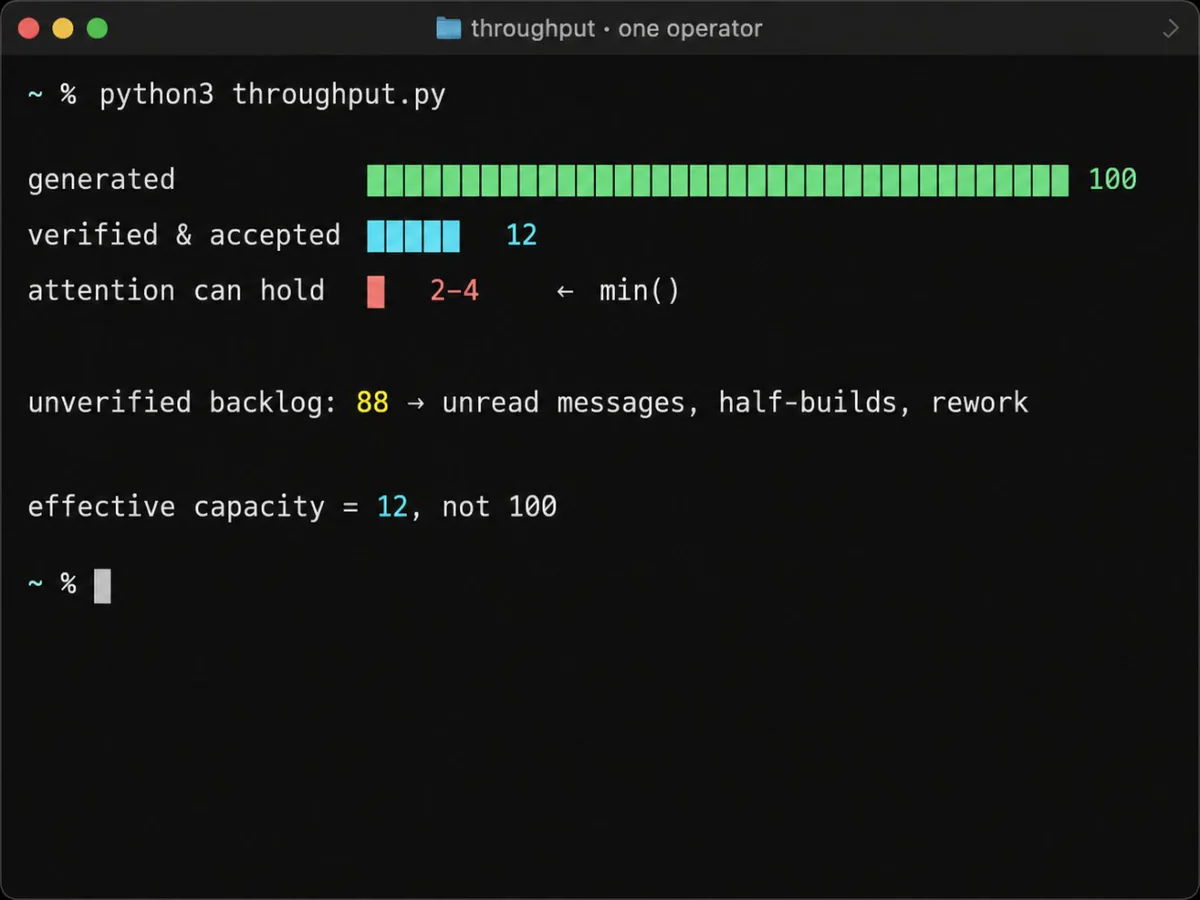
agent 不再是在等算力,而是在等我判断它们的工作能不能验收。
舰队跑得越快,我的验证队列就排得越长。
完成不等于验收
这逼着我把几件之前下意识当成一回事的东西拆开来看:
- 生成的产出
- 技术上成立的产出
- 通过验收的产出
- 真正交付的价值
agent 在提高第一个数字上已经极其擅长。
有了自动化测试,它们也能提高第二个。
但第三个和第四个,仍然高度依赖人的判断,尤其是在涉及模糊需求、UX、品味、优先级和取舍的产品工作里。
所以,只看 token 消耗,能告诉我的东西很少。
一支舰队可以烧掉几百万 token,堆出一大堆看起来很厉害的工作。如果我没法验证、集成并把它交付出去,这堆东西几乎毫无价值。
我现在的模型是:
AI 有效产能 = min(token 带来的算力, 验收能力, 注意力)
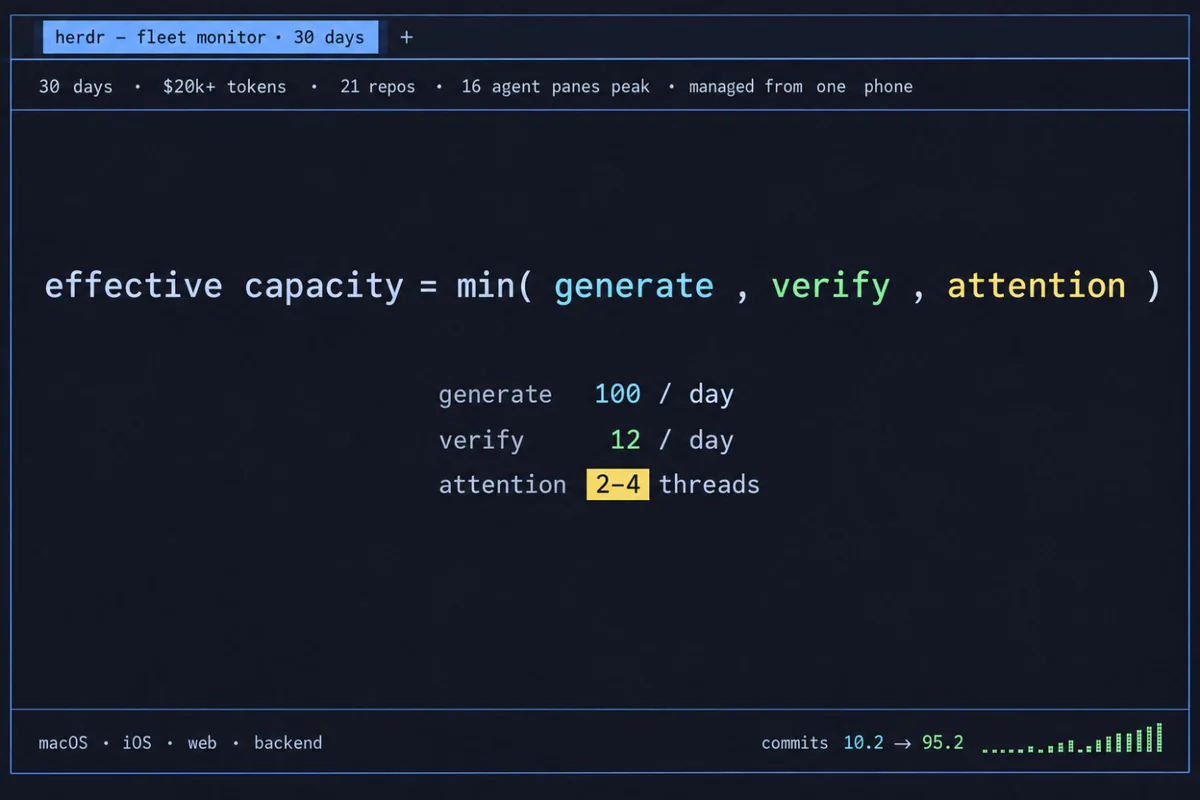
增加算力只在一定范围内有用,直到另外两项中的某一项变得更小为止。
而眼下,验收正在成为我最短的那块木板。
我可能需要研究一下“Acceptance Engineering”
这只是我暂时用的一个说法,并不是一门已经成形的学科。
Acceptance Engineering(验收工程)指的是:在设计工作的时候,就让正确性和有用性变得更容易、更便宜地被验证。
这件事在 agent 写下第一行代码之前就开始了。
“完成”是什么意思?agent 必须交回哪些证据?哪些测试应该通过?应该有哪些截图、日志,或者前后对比?哪些决定可以交给 verifier agent,哪些决定仍然需要我来判断?
目标不是取消人工 review,而是把人的注意力留给价值最高的地方。
- Herdr 可以告诉我哪个 agent 卡住了。
- Lark 可以承载计划、验收标准、决策和证据。
- 自动化测试可以拦下明显的失败。
- Verifier agent 可以独立地挑战实现。
风险分级可以决定一个任务是只需要快速检查一下,还是需要完整走一遍 UAT,又或者需要我从一开始就直接参与。
这比单纯多开几个 agent,是个有意思得多的问题。
管理 agent,成了一面镜子
我开始这个实验,是想知道自己能同时跑多少个 agent。
结果,我发现的是我自己这套 agent 舰队管理体系的极限。
舰队放大了我的能力,也放大了我在思考和管理方式上的每一个弱点。
这也许是最深的一课。
原文以 X Article 形式发表于 2026 年 9 月 13 日。 在 X 上阅读 ↗